Prédiction de Scores de Match de Premier League Anglaise
Contexte du projet
Ce projet de machine learning vise à prédire les scores des matchs de Premier League anglaise en utilisant des données historiques. En exploitant des modèles de régression et des algorithmes d'apprentissage automatique, l'objectif est de fournir des prédictions précises sur les résultats des matchs, en se basant sur des caractéristiques telles que la forme récente des équipes, les statistiques de performance, et d'autres facteurs pertinents.
J'ai essayé plusieurs approches, notamment la régression logistique et les forêts aléatoires, en optimisant les hyperparamètres pour améliorer les performances. Le projet inclut également une analyse approfondie des données pour identifier les caractéristiques les plus influentes dans la prédiction des résultats.
Code Complet
Afficher / masquer le code
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
import pandas as pd
import matplotlib.gridspec as gridspec
from numpy import random
import scipy.stats as scipy
from IPython.display import display
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
from sklearn.ensemble import RandomForestClassifier

def summer_break(team,date,n):
    recent = df[((df['HomeTeam'] == team) | (df['AwayTeam'] == team)) & (df['Date'] < date)]
    recent = recent.sort_values('Date', ascending=False).head(n)
    for i in range (0,len(recent)):
        if recent.iloc[i]['Date'].year != 2020:
            if recent.iloc[i]['Date'].month == 8 and i + 1 < len(recent) and recent.iloc[i + 1]['Date'].month == 5:
                recent = recent.iloc[:i+1]
                break
        else:
            if recent.iloc[i]['Date'].month == 9 and i + 1 < len(recent) and recent.iloc[i + 1]['Date'].month == 7:
                recent = recent.iloc[:i+1]
                break
    return recent
df = pd.read_csv("data/all_seasons.csv",sep=";")   # adapte le nom de fichier
display(df.head())
df['win_or_not'] = (df['FTR'] == 'H').astype(int)  # 1 si victoire domicile, 0 sinon
df['draw_or_lose'] = (df['FTR'] == 'D').astype(int)  # 1 si nul, 0 si défaite
cols=['Unnamed: 0', 'Date', 'HomeTeam', 'AwayTeam', 'FTHG', 'FTAG', 'FTR', 'HTHG', 'HTAG', 'HTR', 'HS', 'AS', 'HST', 'AST', 'HF', 'AF', 'HC', 'AC', 'HY', 'AY', 'HR', 'AR']
df['Date'] = pd.to_datetime(df['Date'], dayfirst=True)
df['result_label'] = df['FTR'].map({
    'H': 'HomeWin',
    'D': 'Draw',
    'A': 'AwayWin'
})
display(df[['HomeTeam','AwayTeam','FTHG','FTAG','FTR','result_label']].head())

home_strength=df.groupby('HomeTeam')['FTHG'].mean()
away_strength=df.groupby('AwayTeam')['FTAG'].mean()
df['home_avg_goals'] = df['HomeTeam'].map(home_strength)
df['away_avg_goals'] = df['AwayTeam'].map(away_strength)

# Feature finale très simple :
df['strength_diff'] = df['home_avg_goals'] - df['away_avg_goals']
#display(df[['HomeTeam','AwayTeam','FTHG','FTAG','FTR','strength_diff']].head())
# X = features, y = label
def forme_recente(equipe, date, n=5):
    recent_matches = df[((df['HomeTeam'] == equipe) | (df['AwayTeam'] == equipe)) & (df['Date'] < date)].sort_values(by='Date', ascending=False).head(n)
    points = 0
    for _, match in recent_matches.iterrows():
        if match['HomeTeam'] == equipe:
            if match['FTR'] == 'H':
                points += 3
            elif match['FTR'] == 'D':
                points += 1
        else:
            if match['FTR'] == 'A':
                points += 3
            elif match['FTR'] == 'D':
                points += 1
    return points
df ['home_recent_form'] = df.apply(lambda row: forme_recente(row['HomeTeam'], row['Date']), axis=1)
df ['away_recent_form'] = df.apply(lambda row: forme_recente(row['AwayTeam'], row['Date']), axis=1)
df['form_diff'] = df['home_recent_form'] - df['away_recent_form']
def forme_saison(equipe, date):
    season_matches = df[((df['HomeTeam'] == equipe) | (df['AwayTeam'] == equipe)) & (df['Date'] < date)]
    points = 0
    for _, match in season_matches.iterrows():
        if match['HomeTeam'] == equipe:
            if match['FTR'] == 'H':
                points += 3
            elif match['FTR'] == 'D':
                points += 1
        else:
            if match['FTR'] == 'A':
                points += 3
            elif match['FTR'] == 'D':
                points += 1
    return points
df ['home_season_form'] = df.apply(lambda row: forme_saison(row['HomeTeam'], row['Date']), axis=1)
df ['away_season_form'] = df.apply(lambda row: forme_saison(row['AwayTeam'], row['Date']), axis=1)
df['season_form_diff'] = df['home_season_form'] - df['away_season_form']

def strength_diff_season(equipe, date):
    season_matches = summer_break(equipe, date, 100)
    if season_matches.empty:
        return 0
    home_goals = season_matches[season_matches['HomeTeam'] == equipe]['FTHG'].sum()
    away_goals = season_matches[season_matches['AwayTeam'] == equipe]['FTAG'].sum()
    total_matches = len(season_matches)
    avg_goals = (home_goals + away_goals) / total_matches
    return avg_goals
df ['home_season_strength'] = df.apply(lambda row: strength_diff_season(row['HomeTeam'], row['Date']), axis=1)
df ['away_season_strength'] = df.apply(lambda row: strength_diff_season(row['AwayTeam'], row['Date']), axis=1)
df['season_strength_diff'] = df['home_season_strength'] - df['away_season_strength']

def recent_offensive_form(team, date, n=5):
    """Buts marqués récemment"""
    recent = summer_break(team, date, n)
    recent = recent.sort_values('Date', ascending=False).head(n)

    goals = 0
    for _, match in recent.iterrows():
        if match['HomeTeam'] == team:
            goals += match['FTHG']
        else:
            goals += match['FTAG']

    return goals / len(recent) if len(recent) > 0 else 0

def recent_defensive_form(team, date, n=5):
    """Buts encaissés récemment"""
    recent = summer_break(team, date, n)
    recent = recent.sort_values('Date', ascending=False).head(n)

    goals_conceded = 0
    for _, match in recent.iterrows():
        if match['HomeTeam'] == team:
            goals_conceded += match['FTAG']
        else:
            goals_conceded += match['FTHG']

    return goals_conceded / len(recent) if len(recent) > 0 else 0

# Applique ces fonctions
df['home_off_form'] = df.apply(lambda x: recent_offensive_form(x['HomeTeam'], x['Date']), axis=1)
df['away_off_form'] = df.apply(lambda x: recent_offensive_form(x['AwayTeam'], x['Date']), axis=1)
df['home_def_form'] = df.apply(lambda x: recent_defensive_form(x['HomeTeam'], x['Date']), axis=1)
df['away_def_form'] = df.apply(lambda x: recent_defensive_form(x['AwayTeam'], x['Date']), axis=1)

df['offensive_advantage'] = df['home_off_form'] - df['away_off_form']
X = df[['offensive_advantage']]

df['defensive_advantage'] = df['away_def_form'] - df['home_def_form']
X = df[['defensive_advantage']]

  # Plus = meilleure défense domicile
df_clean = df.dropna(subset=['strength_diff',  'season_form_diff', 'season_strength_diff','defensive_advantage','offensive_advantage'])
# Ne teste pas tout en même temps !

feature_set = ['strength_diff', 'season_form_diff', 'season_strength_diff', 'defensive_advantage']
X = df_clean[feature_set]
y = df_clean['result_label']
y_win = df_clean['win_or_not']
y_draw = df_clean['draw_or_lose']

# SPLIT PRINCIPAL
X_train, X_test, y_train, y_test = train_test_split(
    X, y,
    test_size=0.2,
    random_state=42,
    stratify=y
)

# Créer y_win et y_draw pour train/test
y_win_train = (y_train == "HomeWin").astype(int)
y_win_test  = (y_test == "HomeWin").astype(int)

y_draw_train = (y_train == "Draw").astype(int)
y_draw_test  = (y_test == "Draw").astype(int)

# --------
# DATASET 2 : uniquement matches NON-gagnés
# --------
non_win_mask_train = (y_win_train == 0)
non_win_mask_test  = (y_win_test == 0)

X_draw_train = X_train[non_win_mask_train]
y_draw_train = y_draw_train[non_win_mask_train]

X_draw_test  = X_test[non_win_mask_test]
y_draw_test  = y_draw_test[non_win_mask_test]


print(f"📊 Données pour le modèle Draw/Lose: {len(X_draw_train)} échantillons")

# Modèles optimisés
models_win = {
    'Random Forest Win': RandomForestClassifier(
        n_estimators=200,
        random_state=42,
        max_depth=10,
        min_samples_leaf=10,
        class_weight='balanced_subsample'
    ),
    'Logistic Regression Win': LogisticRegression(
        solver='lbfgs',
        max_iter=1000,
    )
    , "Random Forest Win custom weights" :RandomForestClassifier(
    n_estimators=150,
    random_state=42,
    max_depth=8,
    min_samples_leaf=15,
    class_weight={0: 1, 1: 3}  # Poids personnalisés
)
}

models_draw = {
    'Random Forest Draw': RandomForestClassifier(
        n_estimators=150,
        random_state=42,
        max_depth=8,
        min_samples_leaf=15,
        class_weight='balanced_subsample'
    ),
    'Logistic Regression Draw': LogisticRegression(
        solver='lbfgs',  # Meilleur pour les petits datasets
        max_iter=1000,
        class_weight='balanced'
    ),
     'Random Forest Draw not balanced': RandomForestClassifier(
        n_estimators=150,
        random_state=42,
        max_depth=8,

    ),
    'Logistic Regression Draw not balanced': LogisticRegression(
        solver='lbfgs',  # Meilleur pour les petits datasets
        max_iter=1000,

    ),'Random Forest Draw custom weights': RandomForestClassifier(
    n_estimators=150,
    random_state=42,
    max_depth=8,
    min_samples_leaf=15,
    class_weight={0: 3, 1: 1}  # Poids personnalisés
)
}

# Entraînement et évaluation
results = []

for win_name, win_model in models_win.items():
    print(f"\n🎯 ENTRAÎNEMENT {win_name}")

    # Modèle Win/NotWin
    win_model.fit(X_train, y_win_train)
    y_win_pred = win_model.predict(X_test)
    win_accuracy = accuracy_score(y_win_test, y_win_pred)

    print(f"Accuracy Win/NotWin: {win_accuracy:.3f}")

    for draw_name, draw_model in models_draw.items():
        print(f"  🔄 Combinaison avec {draw_name}")

        # Modèle Draw/Lose (seulement sur les non-victoires)
        if len(X_draw_train) > 50:  # Assez de données
            draw_model.fit(X_draw_train, y_draw_train)
            # y_draw_pred = draw_model.predict(X_draw_test) # This was the problematic line for combination
            draw_accuracy = accuracy_score(y_draw_test, draw_model.predict(X_draw_test))

            print(f"    Accuracy Draw/Lose: {draw_accuracy:.3f}")

            # Prédictions combinées

            # --- Start of fix ---
            # Create a placeholder for final predictions
            y_final_predictions = np.empty_like(y_test, dtype=object)

            # Assign 'HomeWin' where predicted by the first model
            y_final_predictions[y_win_pred == 1] = "HomeWin"

            # For samples where the first model predicted 'Not HomeWin'
            # Get the subset of X_test for these samples
            X_not_homewin = X_test[y_win_pred == 0]

            if not X_not_homewin.empty:
                # Predict draw/lose for these samples
                y_draw_or_lose_pred = draw_model.predict(X_not_homewin)

                # Get the indices in the original X_test where y_win_pred was 0
                original_indices_not_homewin = np.where(y_win_pred == 0)[0]

                y_final_predictions[original_indices_not_homewin[y_draw_or_lose_pred == 1]] = "Draw"
                y_final_predictions[original_indices_not_homewin[y_draw_or_lose_pred == 0]] = "AwayWin"
            # --- End of fix ---

            y_final = list(y_final_predictions)

            final_accuracy = accuracy_score(y_test, y_final)
            print(y_test, y_final)

            results.append({
                            'Win_Model': win_name,
                            'Draw_Model': draw_name,
                            'Win_Accuracy': win_accuracy,
                            'Draw_Accuracy': draw_accuracy,
                            'Final_Accuracy': final_accuracy,
                            'Win_Samples': len(X_train),
                            'Draw_Samples': len(X_draw_train),

                        })

            print(f"    🎯 Accuracy Finale: {final_accuracy:.3f}")
            print(classification_report(y_test, y_final))
            print(confusion_matrix(y_test, y_final))

# Résultats
results_df = pd.DataFrame(results).sort_values('Final_Accuracy', ascending=False)
print("\n" + "="*60)
print("CLASSEMENT DES COMBINAISONS :")
print(results_df)
Conclusion
Projet en pause car trop complexe pour un débutant en ML, mais le code est complet et commenté pour être réutilisé et amélioré. Il nécessite une bonne compréhension du machine learning, de la manipulation de données, et de l'optimisation de modèles. Les résultats sont encourageants mais peuvent être améliorés avec plus de données, des features engineering plus avancées, et des modèles plus complexes. Je suis actuellement en cours de Ml et j'attends la fin du cours pour revenir dessus avec plus de connaissances et d'expérience.
J'ai quand meme atteint un accuracy de 0,51 ce qui est au dessus de 0,33 (prédiction aléatoire) et j'ai pu identifier des features intéressantes pour la prédiction. j'ai aussi perdu le deroulement de mon travail ou je test differentes features mais les buts moyens restait la meilleur. j'ai arreté parce que je n'arrivais pas a comprendre le tableau de resultats suivant :
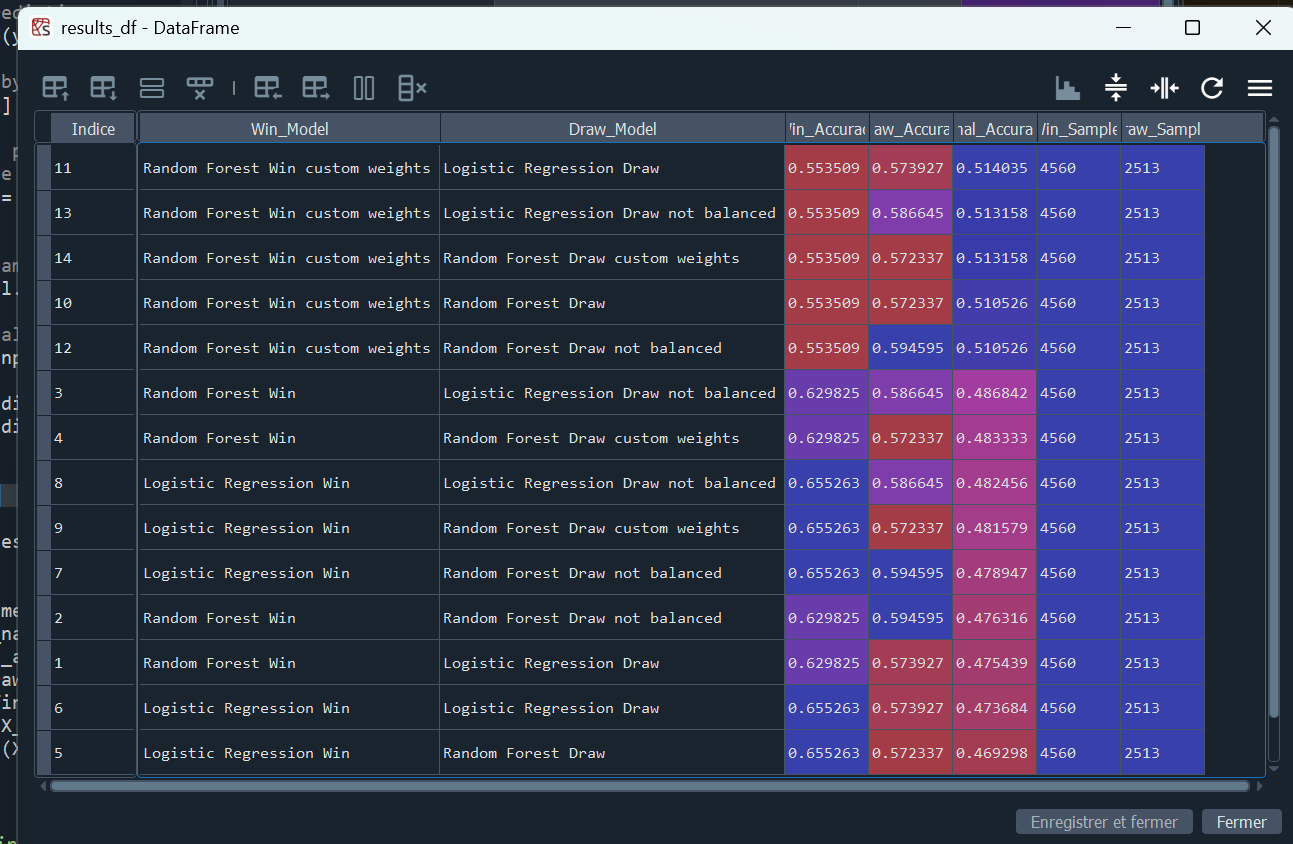
J'ai pas compris comment des modeles peuvent une meilleur Win accuracy et Draw accuracy mais avoir une Final accuracy plus faible, maintenant je sais que c'est parce que les donneés ne sont pas forcement corellees entre elles et que les modeles font des erreurs differentes, du coup la combinaison de leurs erreurs peut faire que la performance finale soit moins bonne que les performances individuelles. C'est un concept important en machine learning, et ça m'a permis de mieux comprendre l'importance de la complémentarité des modèles dans une approche d'ensemble.
Améliorations prévues
- Utilisation de métriques d'évaluation plus adaptées au déséquilibre des classes, comme le F1-Score Macro ou le Log-Loss, à la place de l'Accuracy globale.
- Intégration de nouvelles variables (Feature Engineering) issues du dataset, telles que les tirs cadrés, les corners et les fautes, pour mieux quantifier la domination d'une équipe.
- Implémentation d'un système de notation dynamique (comme le classement Elo ou Pi-Ratings) pour mesurer avec précision la force réelle des équipes au fil de la saison.
- Remplacement du pipeline en deux étapes par un algorithme multiclasse direct basé sur le Gradient Boosting (XGBoost, LightGBM) pour éviter l'accumulation d'erreurs.
- Exploration d'approches statistiques avancées comme la régression de Poisson (modèle de Dixon-Coles) pour prédire les probabilités du nombre de buts de chaque équipe.
- Application de techniques de sur-échantillonnage (comme SMOTE) sur le jeu d'entraînement pour rééquilibrer mathématiquement la détection difficile des matchs nuls.